반도체·디스플레이 공정에서 같은 ALD 레시피를 넣은 두 챔버가 다른 막을 내놓는 일은 드물지 않다. 장비 사이에 공정을 옮겨 본 사람, 같은 플랫폼의 다른 슬롯으로 레시피를 이전해 본 사람이라면 이 차이를 안다.
같은 레시피가 다르게 찍히는 이유
레시피 파일은 설정값을 담을 뿐이다. 결과에 함께 영향을 주는 아래 항목은 레시피에 들어 있지 않다.
- 챔버 벽 상태와 시즈닝 이력
- 서셉터 실제 온도와 기록된 설정값 사이의 차이
- 가스 공급 경로의 형상과 컨덕턴스 차이
- 유지보수 주기 사이에 밀리는 기저 압력
- 세정 뒤 샤워헤드 홀 간 균일도
이 다섯 가지는 레시피에 나타나지 않는다. 레시피 파일이 똑같아도 두 장비는 공정 공간의 서로 다른 지점에 놓일 수 있다.
빌려 온 숫자는 남의 챔버를 데려온다
논문에서 복사해 온 숫자는 남의 장비에서, 논문이 다 밝히지 않았을 수도 있는 조건에서 나온 값이다. 조건 없는 값에 관한 앞 글에서 논문과 내 레시피 사이에 무엇이 빠지는지를 다뤘다. 챔버 간 편차는 같은 문제의 나머지 절반이다. 조건을 전부 밝힌 논문이라 해도 그 조건은 다른 챔버에서 측정된 것이다.
내 조건을 직접 넣는다
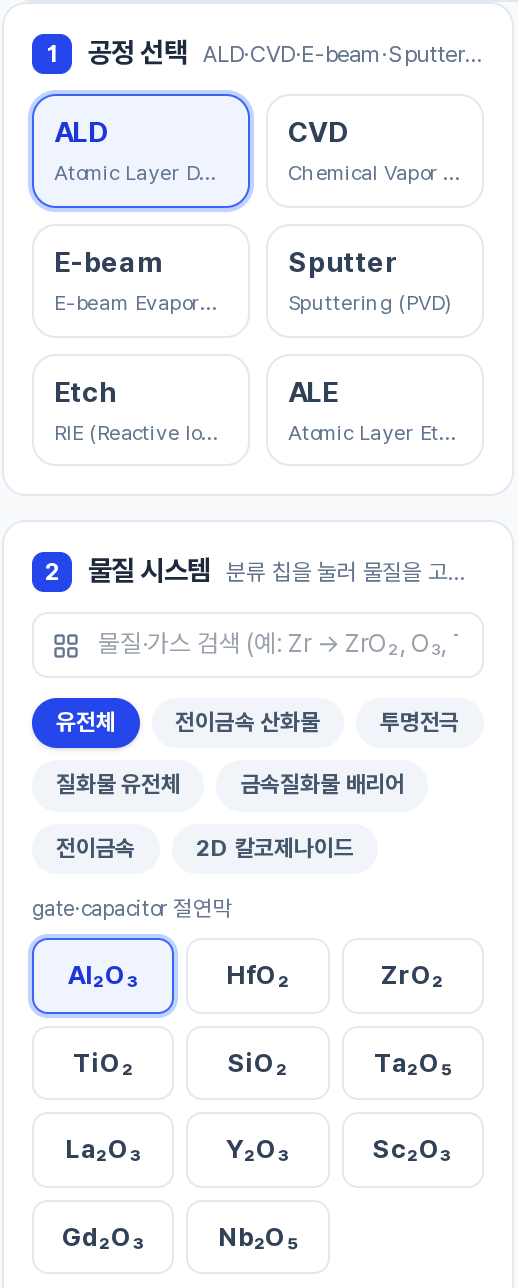
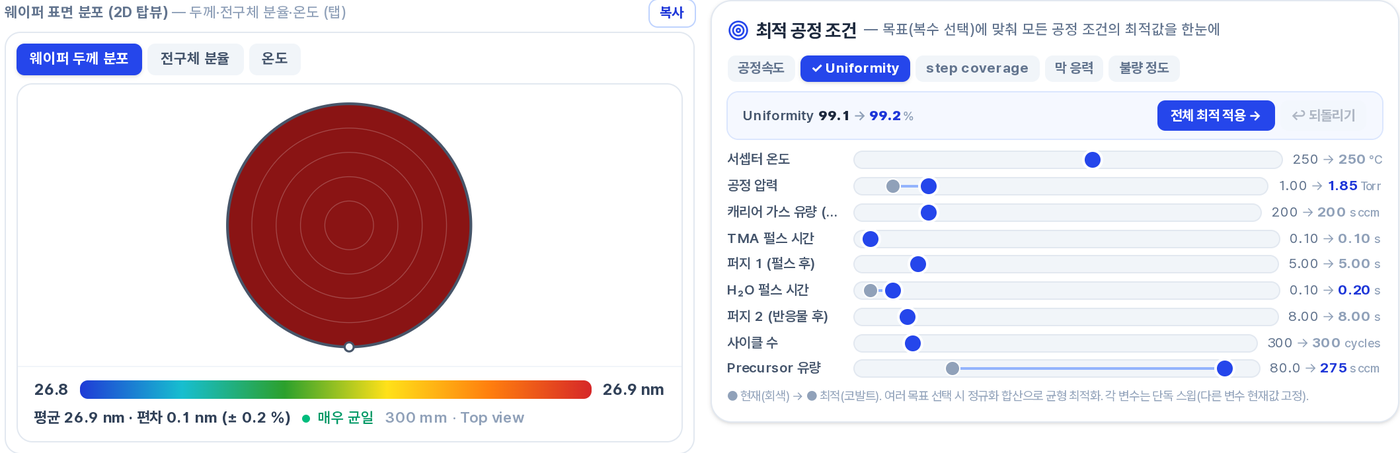
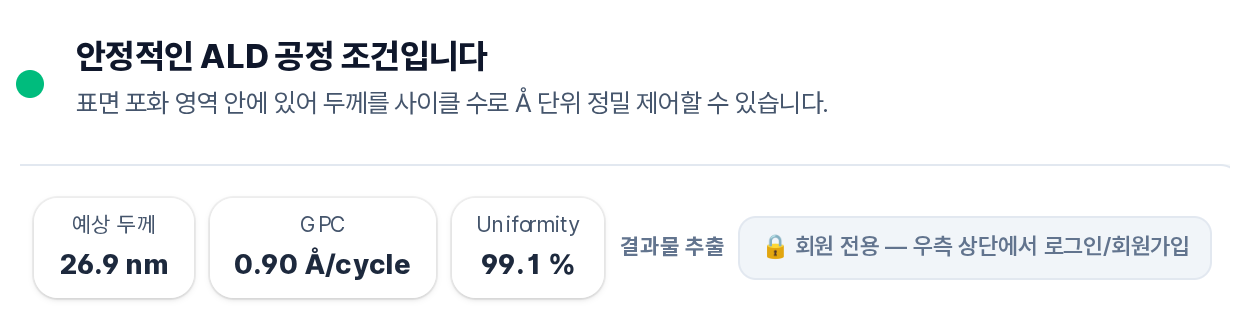
물리 예측은 내가 입력한 조건에 반응한다. 이것이 장비 간 편차를 없애지는 않지만, 출발점을 남의 장비에서 내가 실제로 돌리는 조건으로 옮긴다.
내 실험 데이터를 되먹이기
Semi Process Lab에는 «내 장비 데이터» 화면이 있다.
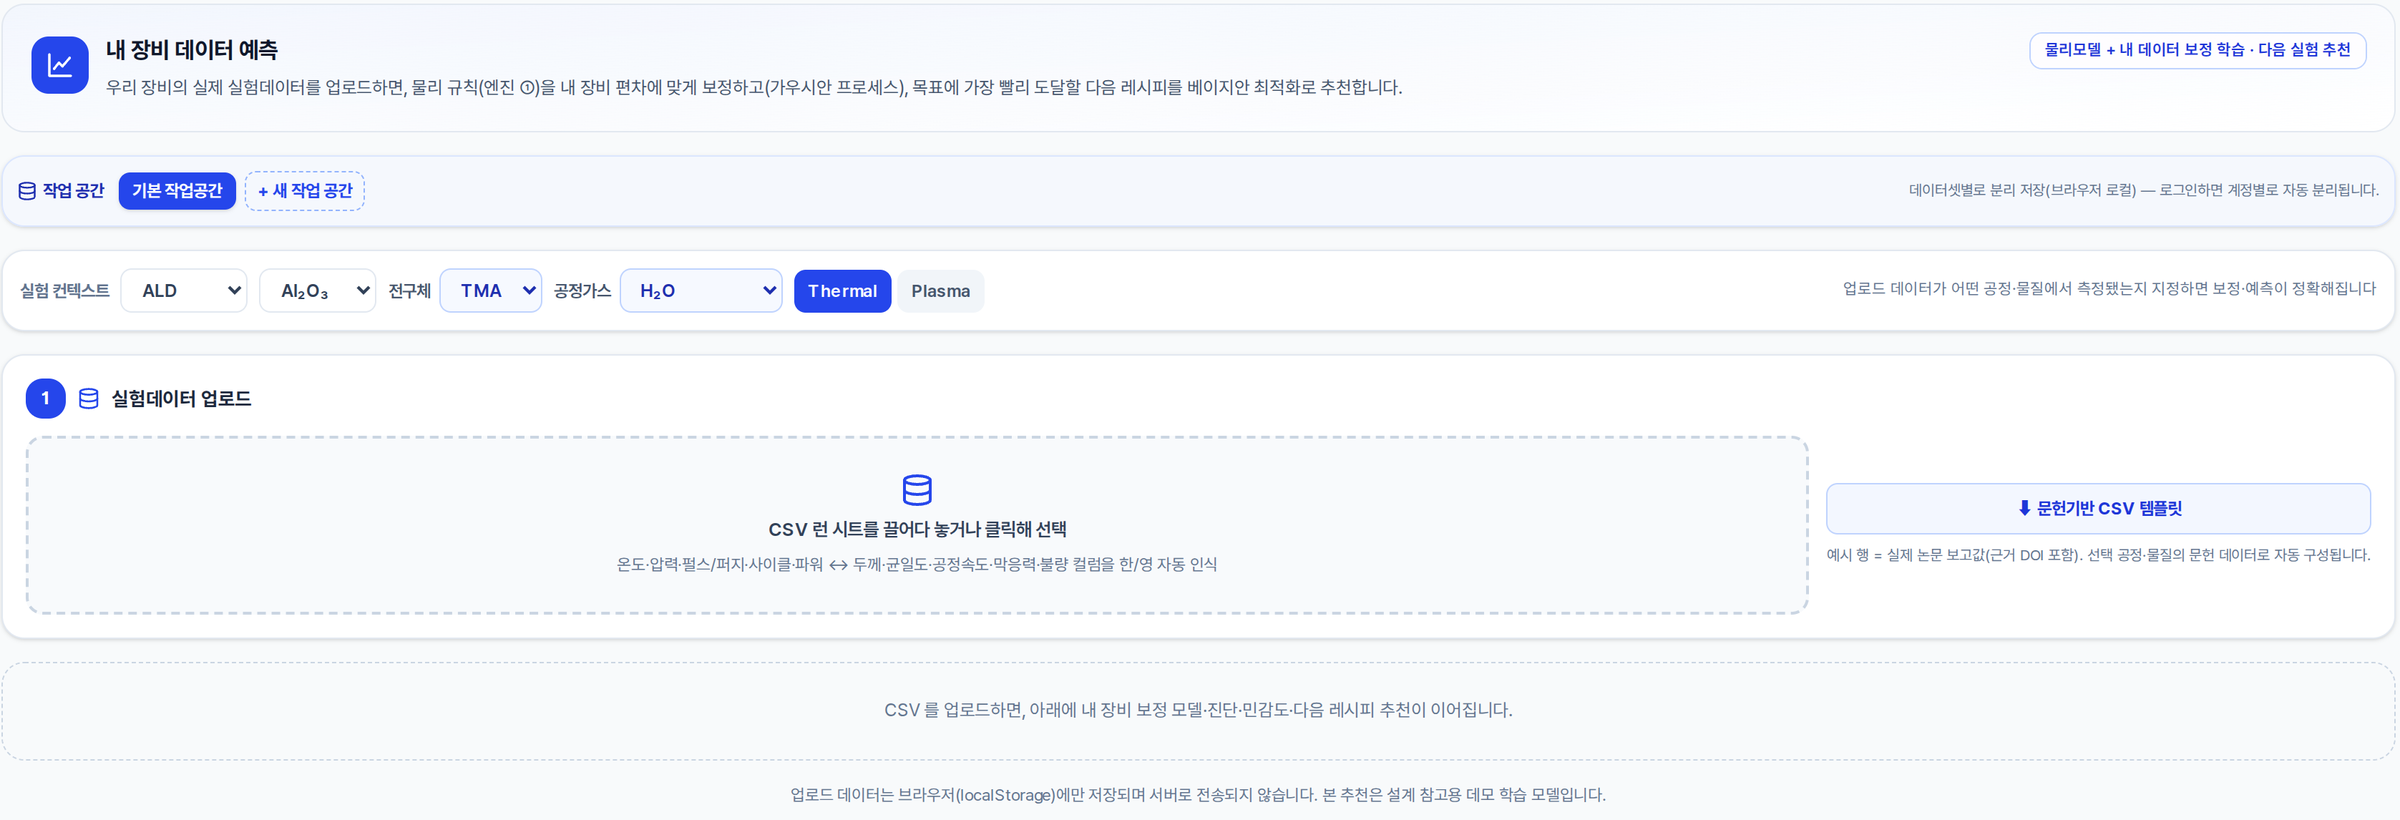
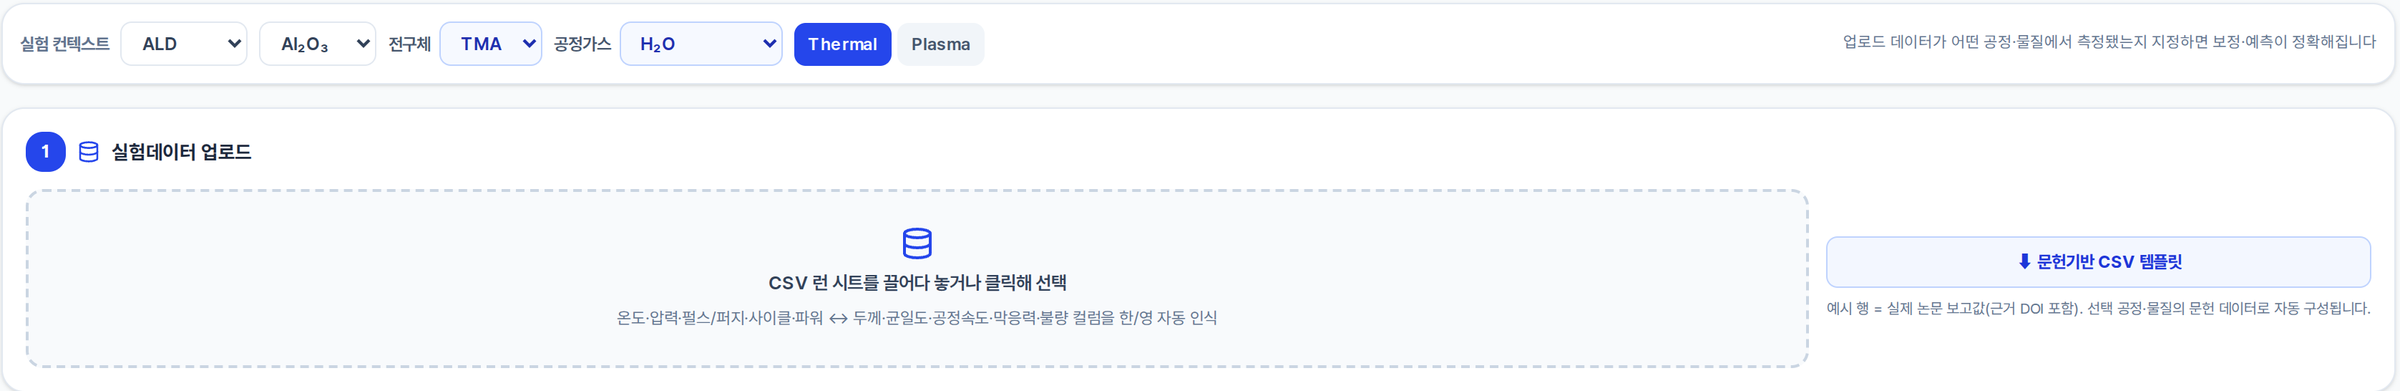
화면의 설명은 이렇다. "우리 장비의 실제 실험데이터를 업로드하면, 물리 규칙(엔진 ①)을 내 장비 편차에 맞게 보정하고(가우시안 프로세스), 목표에 가장 빨리 도달할 다음 레시피를 베이지안 최적화로 추천합니다."
이 말이 뜻하는 바를 정확히 짚는다. 모델이 배우는 것은 물리 예측과 업로드된 측정값 사이의 잔차다. 잔차는 깨끗한 챔버 지문이 아니다 — 모델 오차, 모델이 다루지 않는 조건, 측정 흩어짐이 한 보정에 묶이고, 도구가 나눠 주지 않는다. 같은 화면에는 "업로드 데이터는 브라우저(localStorage)에만 저장되며 서버로 전송되지 않습니다. 본 추천은 설계 참고용 데모 학습 모델입니다."라고 적혀 있고, 페이지 하단에는 "본 예측은 공정 설계 참고용이며 실제 실험·검증을 대체하지 않습니다."라고 적혀 있다.
자주 묻는 질문
이 기능이 내 챔버의 퀄리피케이션 런을 대신하나?
아니다. 화면 자체에 예측은 공정 설계 참고용이며 실제 실험이나 검증을 대신하지 않는다고 적혀 있다.
모델은 내 데이터에서 무엇을 배우나?
물리 예측과 내 측정값 사이의 잔차를 배운다. 잔차에는 챔버 고유 효과가 들어 있지만, 모델 오차와 측정 흩어짐도 섞여 있다. 이를 분리해서 보여 주지는 않는다.
업로드한 데이터가 서버로 전송되나?
아니다. 화면에 업로드 데이터는 브라우저에만 저장되고 서버로 보내지 않는다고 명시돼 있다.
논문에서 가져온 숫자에 장비 간 편차가 더 큰 이유는?
모르는 것이 두 겹으로 쌓이기 때문이다. 논문이 조건을 전부 밝히지 않았을 수 있고, 밝힌 조건이라 해도 다른 챔버에서 측정된 값이다. 내 조건을 직접 넣으면 첫 번째 모르는 것이 사라진다. 두 번째는 내 장비를 직접 돌려야 해소된다.